Desarrollador full stack
Kadir Ramírez
Creo sitios web y sistemas a la medida de tu proyecto.
Antes de empezar acordamos qué incluye el trabajo, qué queda fuera y cuánto cuesta.
- Ahora
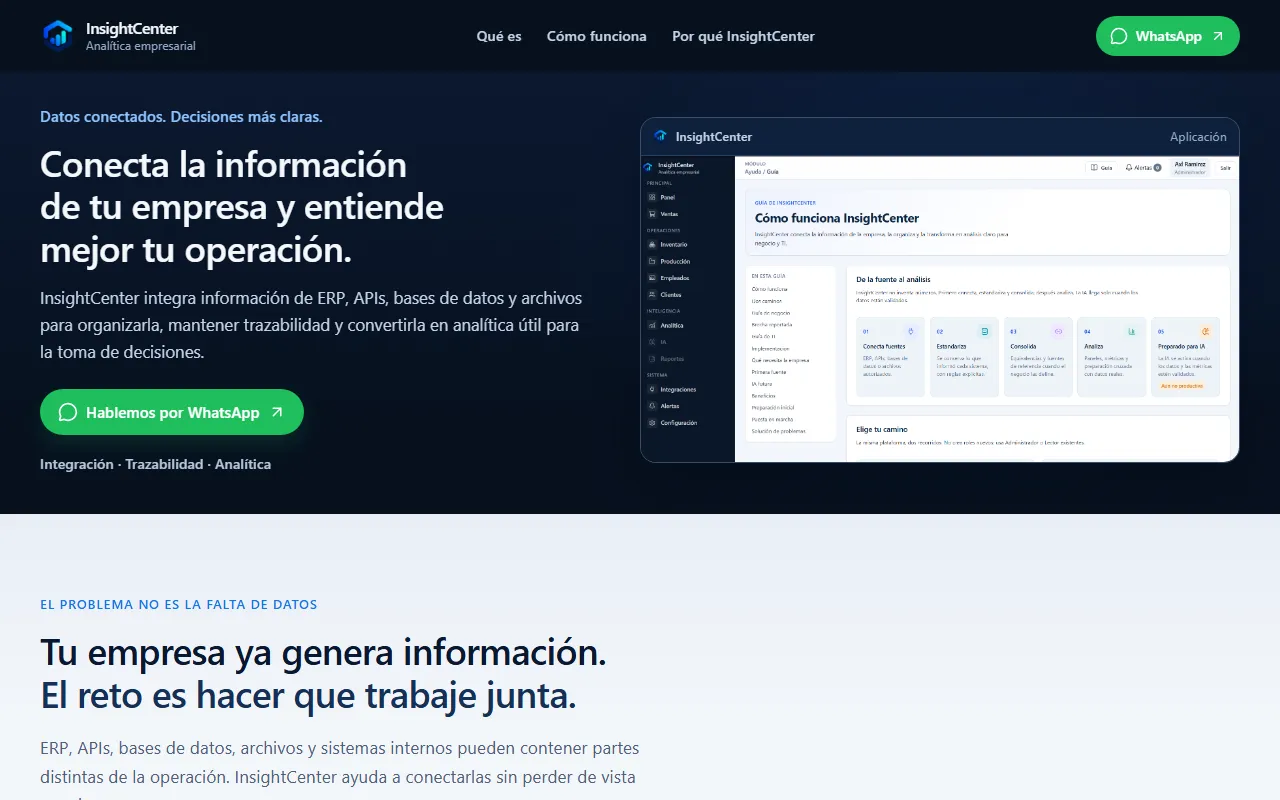
- Desarrollo InsightCenter, una plataforma de integración y analítica.
- Antes
- Software Developer en Moovin Logistics, de 2023 a 2025.
Servicios
Dos formas de trabajar juntos. En las dos, antes de empezar dejamos por escrito qué incluye el trabajo.
Sitios web y landing pages
Para presentar un negocio, un servicio o un proyecto personal en una página clara, que se vea bien en el teléfono y lleve a la gente a escribirte.
- Rango orientativo
- US$350–500
- El precio final depende de los requisitos que acordemos.
Escribir por WhatsApp sobre un sitio web o landing page (se abre en una pestaña nueva)Enviar un correo sobre un sitio web o landing pageVer qué incluyeOcultar detalles: Sitios web y landing pages
Puede incluir
- Diseño responsive, pensado primero para el teléfono.
- Desarrollo del sitio y su publicación.
- Entre 5 y 8 secciones, según el alcance que acordemos.
- Enlaces o botones de contacto por WhatsApp y correo.
- SEO técnico básico: títulos, descripciones, encabezados ordenados y una carga ligera.
Se detalla en la propuesta
- El dominio del primer año, si está disponible y según el costo que acordemos.
- A nombre de quién queda el dominio, cómo se renueva, dónde se aloja el sitio y qué servicios de terceros intervienen.
No incluye, salvo que lo acordemos aparte
- Páginas independientes para cada sección: las secciones forman parte de un mismo sitio.
- Formularios que guarden o procesen datos en un servidor.
- Pagos en línea.
- Redacción de los textos: el contenido lo aportas tú y te indico qué necesita cada sección.
- Mantenimiento ilimitado ni posiciones garantizadas en buscadores.
Sistemas web a medida
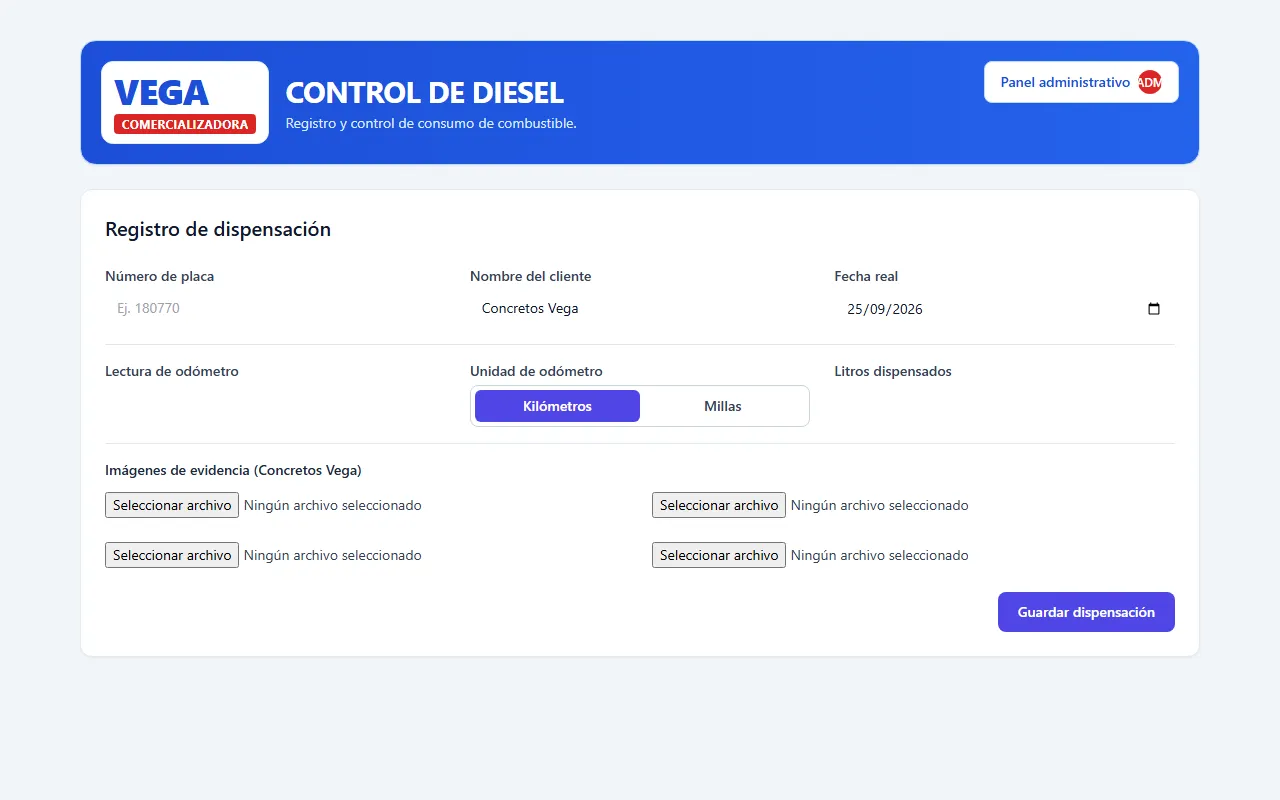
Para proyectos personales o empresariales que necesitan una herramienta propia: un registro de operaciones, un inventario o un panel de administración. Primero conversamos sobre los requisitos y después preparo una cotización.
- Precio
- Según cotización
- No doy un precio antes de entender el proyecto: cada sistema cambia según lo que tenga que hacer.
Escribir por WhatsApp sobre un sistema web a medida (se abre en una pestaña nueva)Enviar un correo sobre un sistema web a medidaVer qué incluyeOcultar detalles: Sistemas web a medida
Antes de cotizar
Requisitos y usuarios
Qué problema resuelve el sistema, quién lo va a usar y qué necesita hacer cada persona.
Funciones, integraciones y datos
Qué funciones hacen falta, con qué otros sistemas se conecta y qué información guarda o consulta.
Seguridad
Quién puede ver o cambiar cada cosa y cómo se protege la información.
Etapas
Dividimos el trabajo en entregas que puedas probar antes de seguir con la siguiente.
Cotización
Con todo eso definido, preparo una cotización por etapas.
Prompts gratuitos
Cuatro prompts para pedirle a un asistente de IA una revisión de tu proyecto con evidencia. Completa lo que está entre corchetes antes de enviarlos y revisa lo que te responda: la IA también se equivoca.
Auditoría de código y funcionalidades
Para saber si el proyecto hace lo que dice y dónde está el código frágil antes de seguir construyendo.
- Funcionalidades frente a lo esperado
- Errores y casos límite
- Código muerto y duplicado
- Pruebas y documentación
Ver el prompt completo: Auditoría de código y funcionalidades
Actúa como revisor técnico sénior. Vas a auditar el código y las funcionalidades de un proyecto.

## Contexto (complétalo antes de enviar)
- Proyecto y para qué sirve: [describe el proyecto y a quién va dirigido]
- Stack y versiones: [lenguajes, frameworks, base de datos]
- Cómo se ejecuta: [comandos de instalación, desarrollo, build y pruebas]
- Funcionalidades que deben revisarse: [lista de funciones y cómo deberían comportarse]
- Fuera del alcance: [partes que no hay que revisar]
- Restricciones: [por ejemplo: solo lectura, sin instalar dependencias, fecha límite, partes que no se pueden cambiar]

Si falta algo de este contexto que necesites, pregúntalo antes de empezar o indica qué supusiste.

## Qué revisar
1. Que cada funcionalidad de la lista haga lo que se espera: flujo principal, casos límite, datos vacíos o inválidos, errores y estados de carga.
2. Manejo de errores: excepciones silenciadas, promesas sin capturar, mensajes que no ayudan a resolver el problema.
3. Validación de datos en los bordes: entradas de usuario, respuestas de APIs, archivos y variables de entorno.
4. Lógica duplicada, código muerto, dependencias sin uso y configuraciones que se contradicen.
5. Pruebas: qué cubren, qué flujos importantes no tienen pruebas y qué pruebas pasan sin comprobar nada útil.
6. Documentación y comentarios que ya no describen el código.

## Cómo trabajar
- Lee el código o el material antes de opinar. No supongas cómo funciona algo que no abriste.
- Cita cada hallazgo con archivo y línea (por ejemplo, src/api/users.ts:42) y un extracto breve del código.
- Separa los hallazgos comprobados (los viste en el código o los reprodujiste) de las hipótesis (sospechas sin confirmar). Para cada hipótesis, indica qué habría que revisar o ejecutar para confirmarla o descartarla.
- Si te falta información para evaluar algo, dilo y pregunta. No completes los huecos con suposiciones presentadas como hechos.
- No modifiques archivos, no instales dependencias y no ejecutes comandos que cambien datos o configuración, salvo que te lo pida expresamente.

## Formato de la respuesta
1. Resumen de cinco líneas como máximo.
2. Hallazgos comprobados, ordenados por prioridad. Para cada uno: evidencia (archivo:línea), qué pasa, a quién afecta, cómo reproducirlo, corrección propuesta y cómo verificar que quedó resuelto.
3. Hipótesis por confirmar, cada una con la prueba concreta que la confirmaría o descartaría.
4. Qué no pudiste revisar y por qué.
5. Plan de trabajo en orden, empezando por lo que más reduce el riesgo con menos esfuerzo.

Prioridades: crítica (pérdida de datos, caída o exposición grave; atender ya), alta (afecta a muchos usuarios o a un flujo principal), media (problema real con alternativa o impacto limitado), baja (mejora o limpieza).
QA funcional y accesibilidad
Para probar los flujos como lo haría una persona usuaria, incluidas las que usan teclado o lector de pantalla.
- Flujos críticos de principio a fin
- Teclado y foco
- Lectores de pantalla
- Contraste, zoom y móvil
Ver el prompt completo: QA funcional y accesibilidad
Actúa como especialista en QA funcional y accesibilidad web. Vas a revisar una aplicación como la usaría una persona real.

## Contexto (complétalo antes de enviar)
- Qué hace la aplicación y quién la usa: [descripción]
- Cómo acceder: [URL de un entorno de pruebas o cómo ejecutarla en local]
- Usuarios o datos de prueba: [cuentas ficticias; no compartas datos ni contraseñas reales]
- Flujos críticos: [por ejemplo: registro, compra, envío de un formulario]
- Navegadores y dispositivos que deben funcionar: [lista]
- Criterio de accesibilidad: [por ejemplo: WCAG 2.2 nivel AA]
- Restricciones: [por ejemplo: no crear registros en producción, solo revisar el código]

Si falta algo de este contexto que necesites, pregúntalo antes de empezar o indica qué supusiste.

## Qué revisar
1. Flujos críticos de principio a fin con datos válidos, inválidos, vacíos, en el límite y repetidos. Incluye doble clic, recargar la página, atrás y adelante, conexión lenta y pérdida de conexión.
2. Teclado: todo se puede usar con Tab, Mayús+Tab, Enter, Espacio, flechas y Escape; el orden de tabulación sigue el orden visual; el foco siempre se ve; no hay trampas de foco, y al cerrar un diálogo el foco vuelve a su origen.
3. Lectores de pantalla: nombres accesibles de botones y enlaces, roles y estados (aria-expanded, aria-current, aria-invalid), anuncio de mensajes de error y confirmaciones, jerarquía de encabezados, regiones y textos alternativos.
4. Formularios: etiquetas visibles, instrucciones antes del campo, errores asociados al campo que los provoca y que no dependen solo del color.
5. Contraste de texto y controles, zoom al 200 %, reflujo a 320 px de ancho sin desplazamiento horizontal, tamaño de los objetivos táctiles y preferencia de movimiento reducido.
6. Estados vacíos, de carga y de error en cada pantalla.

Las herramientas automáticas (axe, Lighthouse) detectan solo una parte de los problemas de accesibilidad. Úsalas como apoyo, pero no des por accesible algo solo porque las pasa: indica qué comprobaste a mano.

## Cómo trabajar
- Lee el código o el material antes de opinar. No supongas cómo funciona algo que no abriste.
- Cita cada hallazgo con archivo y línea (por ejemplo, src/api/users.ts:42) y un extracto breve del código.
- Separa los hallazgos comprobados (los viste en el código o los reprodujiste) de las hipótesis (sospechas sin confirmar). Para cada hipótesis, indica qué habría que revisar o ejecutar para confirmarla o descartarla.
- Si te falta información para evaluar algo, dilo y pregunta. No completes los huecos con suposiciones presentadas como hechos.
- No modifiques archivos, no instales dependencias y no ejecutes comandos que cambien datos o configuración, salvo que te lo pida expresamente.
- Para lo que observes en la aplicación y no en el código, da como evidencia la URL, los pasos exactos, el navegador y lo que esperabas frente a lo que ocurrió. Si encuentras la causa en el código, añade archivo y línea.

## Formato de la respuesta
1. Resumen de cinco líneas como máximo.
2. Hallazgos comprobados, ordenados por prioridad. Para cada uno: pasos para reproducirlo, resultado esperado y obtenido, evidencia, criterio WCAG afectado si aplica, corrección propuesta y cómo volver a probarlo.
3. Hipótesis por confirmar, con la prueba que las confirmaría o descartaría.
4. Qué no pudiste probar (navegadores, lectores de pantalla, dispositivos, flujos) y por qué.
5. Lista de casos de prueba para repetir después de las correcciones.

Prioridades: crítica (pérdida de datos, caída o exposición grave; atender ya), alta (afecta a muchos usuarios o a un flujo principal), media (problema real con alternativa o impacto limitado), baja (mejora o limpieza).
Seguridad de frontend, backend, autenticación y datos
Para encontrar riesgos concretos en el código y la configuración. Es una revisión, no una certificación.
- Autorización en el servidor
- Autenticación y sesiones
- Entradas, secretos y datos
- Lo que quedó sin auditar
Ver el prompt completo: Seguridad de frontend, backend, autenticación y datos
Actúa como revisor de seguridad de aplicaciones web. Vas a revisar el frontend, el backend, la autenticación y el manejo de datos de un proyecto.

Esta revisión no es una certificación de seguridad ni garantiza que el sistema sea seguro: se limita al material y al tiempo disponibles. Dilo así en tu respuesta.

## Contexto (complétalo antes de enviar)
- Arquitectura: [frontend, backend, base de datos, servicios de terceros y dónde se despliega cada parte]
- Autenticación: [método: sesiones, JWT, OAuth, Firebase Auth, etc.]
- Roles y permisos: [qué puede ver y hacer cada tipo de usuario]
- Datos sensibles: [datos personales, pagos, documentos, credenciales]
- Qué material compartes: [repositorio completo, solo frontend, reglas de base de datos, configuración]
- Qué tienes permiso de probar: [solo leer código / entorno de pruebas propio]. No hagas pruebas contra producción ni con datos reales.
- Restricciones: [por ejemplo: solo lectura, sin instalar herramientas, partes que no se pueden cambiar, fecha límite]

Si falta algo de este contexto que necesites, pregúntalo antes de empezar o indica qué supusiste.

## Qué revisar
1. Autorización en el servidor. Si hay backend, comprueba en cada endpoint, función o regla que lee o modifica datos que el servidor verifica quién hace la petición y si tiene permiso sobre ese recurso concreto, no solo que haya iniciado sesión (por ejemplo, cambiar un id en la URL para ver datos ajenos). Ocultar un botón o una ruta en el frontend no es control de acceso. Si se usa Firebase, Supabase u otro backend gestionado, revisa sus reglas de seguridad o políticas de filas.
2. Autenticación y sesiones: dónde se guardan los tokens, expiración y renovación, cierre de sesión, recuperación de contraseña y límite de intentos.
3. Entradas: inyección SQL, NoSQL o de comandos; XSS (innerHTML, dangerouslySetInnerHTML, plantillas sin escapar); subida de archivos; validación en el servidor y no solo en el cliente.
4. Secretos: claves o contraseñas en el repositorio, en el historial de git, en el JavaScript que se envía al navegador o en variables públicas (VITE_, NEXT_PUBLIC_, etc.).
5. Datos: respuestas que devuelven más campos de los necesarios, datos personales en logs, cifrado en tránsito y copias de seguridad.
6. Configuración: CORS, cookies (HttpOnly, Secure, SameSite), protección CSRF, cabeceras como Content-Security-Policy y mensajes de error que revelan detalles internos.
7. Dependencias con vulnerabilidades conocidas, indicando si la parte vulnerable se usa realmente en el proyecto.

Si en el material no hay backend o no está completo, dilo de forma explícita y no des la autorización por buena: explica qué habría que revisar en el servidor.

## Cómo trabajar
- Lee el código o el material antes de opinar. No supongas cómo funciona algo que no abriste.
- Cita cada hallazgo con archivo y línea (por ejemplo, src/api/users.ts:42) y un extracto breve del código.
- Separa los hallazgos comprobados (los viste en el código o los reprodujiste) de las hipótesis (sospechas sin confirmar). Para cada hipótesis, indica qué habría que revisar o ejecutar para confirmarla o descartarla.
- Si te falta información para evaluar algo, dilo y pregunta. No completes los huecos con suposiciones presentadas como hechos.
- No modifiques archivos, no instales dependencias y no ejecutes comandos que cambien datos o configuración, salvo que te lo pida expresamente.
- No incluyas en tu respuesta secretos completos que encuentres: indica dónde están y muestra solo los primeros caracteres.

## Formato de la respuesta
1. Alcance: qué revisaste y qué material no tenías.
2. Hallazgos comprobados, ordenados por prioridad según el impacto y la facilidad de explotación. Para cada uno: evidencia (archivo:línea), escenario de abuso, datos o usuarios afectados, corrección propuesta y cómo verificar que quedó cerrado.
3. Hipótesis por confirmar, con la prueba concreta, segura y autorizada que las confirmaría o descartaría.
4. Qué no pudiste auditar y por qué: por ejemplo, infraestructura, configuración del servidor, servicios de terceros, código no compartido o pruebas dinámicas que no se hicieron.
5. Plan de corrección en orden.

Prioridades: crítica (pérdida de datos, caída o exposición grave; atender ya), alta (afecta a muchos usuarios o a un flujo principal), media (problema real con alternativa o impacto limitado), baja (mejora o limpieza).
Arquitectura, escalabilidad y rendimiento
Para decidir qué mejorar con datos: primero se mide y después se recomienda infraestructura.
- Mediciones antes que recomendaciones
- Base de datos y backend
- Carga del frontend
- Operación y despliegue
Ver el prompt completo: Arquitectura, escalabilidad y rendimiento
Actúa como arquitecto de software. Vas a revisar la arquitectura, la capacidad de crecer y el rendimiento de un proyecto.

## Contexto (complétalo antes de enviar)
- Arquitectura actual: [componentes, cómo se comunican y dónde se despliegan]
- Uso actual: [usuarios, peticiones por minuto, volumen de datos]
- Uso esperado y en qué plazo: [crecimiento previsto]
- Objetivos: [por ejemplo: p95 de la API por debajo de 300 ms, LCP por debajo de 2,5 s en móvil]
- Mediciones disponibles: [métricas, logs, trazas, informes de Lighthouse, consultas lentas; pega los datos si los tienes]
- Presupuesto y equipo: [cuánto se puede gastar en infraestructura y quién mantiene el sistema]
- Restricciones: [proveedor fijo, tecnologías que no se pueden cambiar, fecha límite]

Si falta algo de este contexto que necesites, pregúntalo antes de empezar o indica qué supusiste.

## Primero, las mediciones
Antes de recomendar infraestructura nueva (caché, colas, réplicas, microservicios, más servidores u otro proveedor), revisa las mediciones que te di. Si no hay datos suficientes, tu primera recomendación debe ser qué medir y cómo (por ejemplo: tiempos de respuesta p50 y p95 por endpoint, consultas lentas, uso de CPU y memoria, tamaño de los bundles, Core Web Vitals de usuarios reales), no qué comprar. Si la arquitectura actual alcanza para los objetivos, dilo.

## Qué revisar
1. Límites entre módulos y dependencias entre capas: acoplamiento que obliga a tocar varias partes para cambiar una.
2. Base de datos: consultas N+1, índices que faltan, consultas sin paginar, transacciones y tamaño de las respuestas.
3. Backend: trabajo pesado dentro de la petición, llamadas externas sin tiempo de espera ni reintentos, estado en memoria que impide tener más de una instancia.
4. Frontend: tamaño del JavaScript inicial y carga diferida, renders innecesarios, listas largas sin paginar, imágenes y fuentes.
5. Operación: logs, métricas, alertas, copias de seguridad, y cómo se despliega y se revierte un cambio.

## Cómo trabajar
- Lee el código o el material antes de opinar. No supongas cómo funciona algo que no abriste.
- Cita cada hallazgo con archivo y línea (por ejemplo, src/api/users.ts:42) y un extracto breve del código.
- Separa los hallazgos comprobados (los viste en el código o los reprodujiste) de las hipótesis (sospechas sin confirmar). Para cada hipótesis, indica qué habría que revisar o ejecutar para confirmarla o descartarla.
- Si te falta información para evaluar algo, dilo y pregunta. No completes los huecos con suposiciones presentadas como hechos.
- No modifiques archivos, no instales dependencias y no ejecutes comandos que cambien datos o configuración, salvo que te lo pida expresamente.
- Un cuello de botella solo es comprobado si una medición lo muestra. Si lo deduces del código, preséntalo como hipótesis e indica qué medición lo confirmaría.

## Formato de la respuesta
1. Resumen de cinco líneas como máximo.
2. Mediciones revisadas y qué muestran; indica «sin medición» donde falten datos.
3. Hallazgos comprobados, ordenados por prioridad. Para cada uno: evidencia (medición y archivo:línea), impacto, recomendación, costo y complejidad aproximados, y cómo verificar la mejora repitiendo la misma medición antes y después.
4. Hipótesis por confirmar, con la medición que las confirmaría o descartaría.
5. Qué no pudiste revisar y por qué.
6. Plan por etapas, empezando por la opción más simple que cumpla los objetivos.

Prioridades: crítica (pérdida de datos, caída o exposición grave; atender ya), alta (afecta a muchos usuarios o a un flujo principal), media (problema real con alternativa o impacto limitado), baja (mejora o limpieza).